執行這個策略
複製提示詞,讓 AI 依照上方證據的資料、條件與風險檢查重跑一次。
告訴你的AI:
幫我設定 FinLab,做月營收成長動能策略並排程每月重跑,請讀:https://finlab.finance/setup?relatedUrl=/blog/hermes-agent-finlab-walk-forward
用 Hermes Agent 跑 finlab,最常卡住的其實是環境選擇:Hermes 要怎麼裝、模型要選雲端還是本機、排程要放在自己的電腦還是 VPS、第一次取台股資料時要設定哪些東西。本文把上手流程放在最前面,再用一支「月營收成長動能三因子」策略當範例,示範 Hermes 每月台股營收公布後自動重跑、跟上月比對、把衰退寫進記憶。
| 上手問題 | 直接建議 |
|---|---|
| Hermes 怎麼裝 | macOS/Windows 新手用 Hermes Desktop;熟命令列用官方安裝指令 |
| AI 模型怎麼選 | 第一次用 hermes setup --portal 最省事;量化研究主力選強工具調用模型,本地模型適合隱私與低成本實驗 |
| 需要買雲端 GPU 嗎 | 多數人不用。用雲端 API 模型時,普通筆電或小型 VPS 就能跑 Hermes;只有自架大型本地模型才需要 GPU |
| 本機還是雲端 | 學習、手動重跑用本機;要每月自動執行、手機收通知,用 VPS 或 serverless 環境更穩 |
| finlab 初始設定 | 裝 finlab skill 後交給下方 setup 提示詞,首次取資料時套件會自動引導登入 |
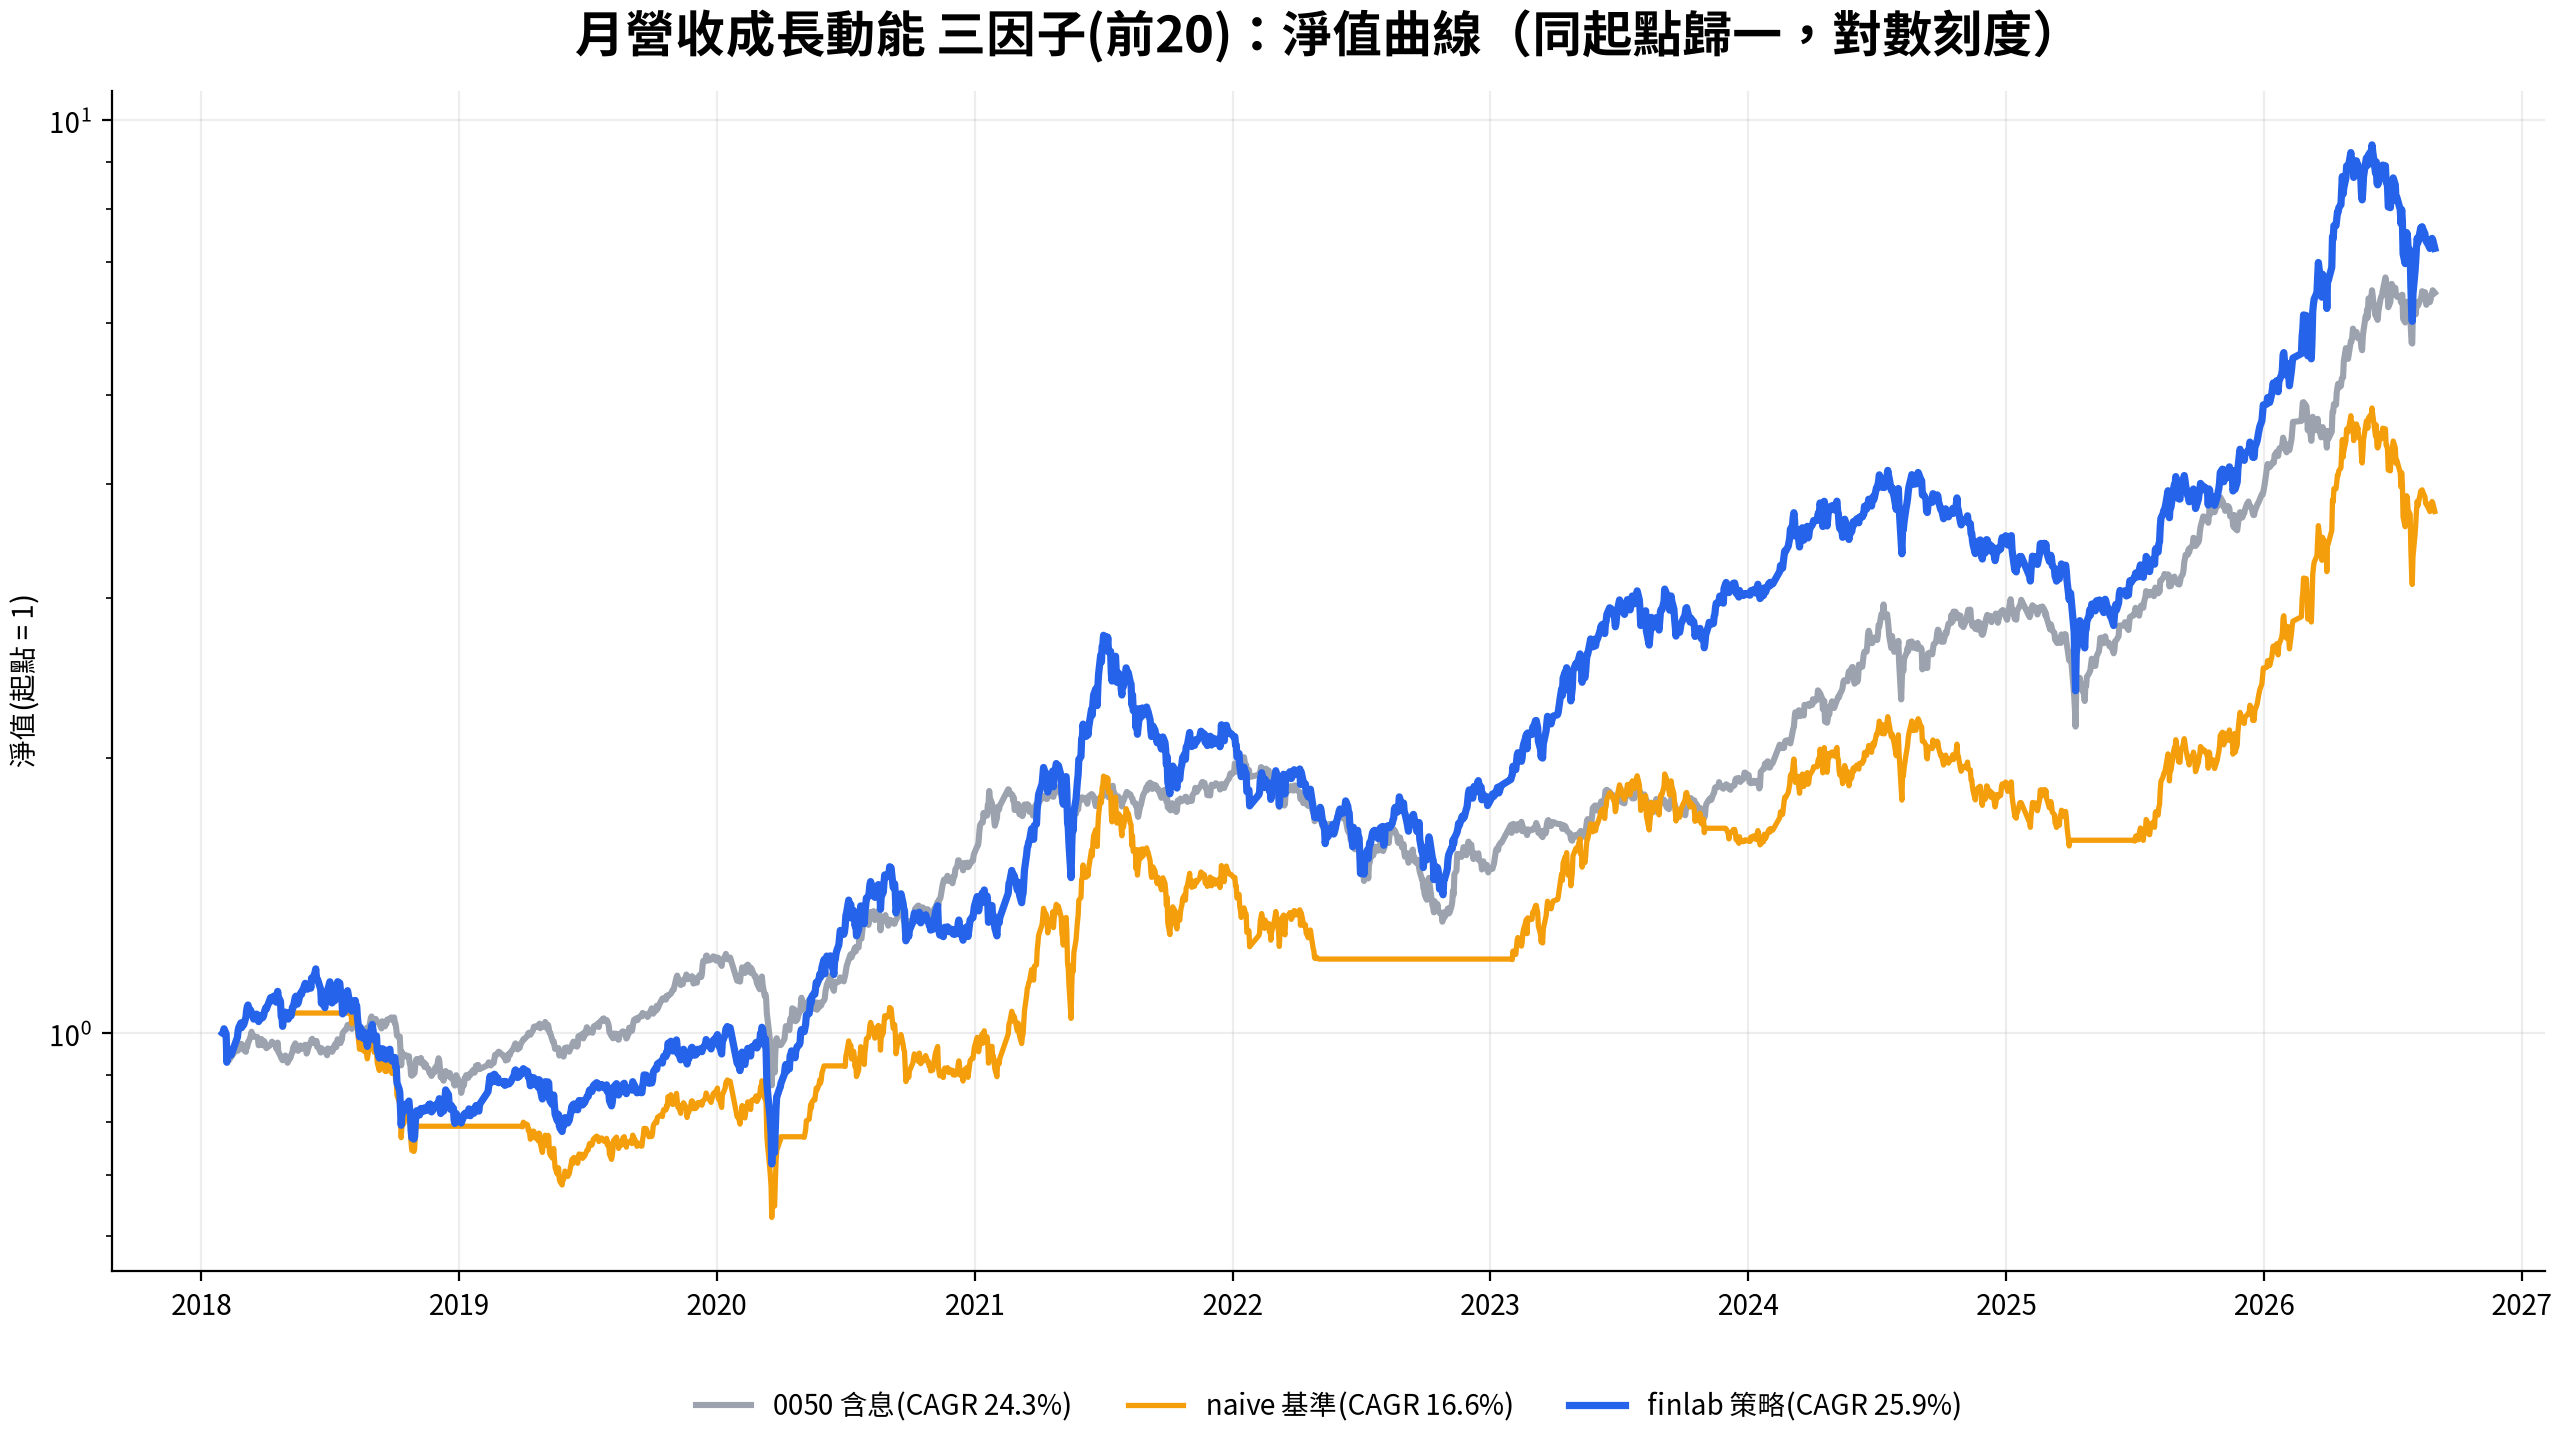
策略範例的實測結果也放在同一篇:配合 walk-forward(研究段對樣本外)驗證,全段(2018-01 到 2026-08)年化報酬(CAGR)25.9%、月索提諾 1.67;樣本外段(2022 之後)年化 30.3%,與同期 0050 含息的 29.6% 幾乎打平。與 2026-06 快照相比,數字明顯回落。這些數字用來說明 Hermes 接上 finlab 後能維護什麼;要實單,仍得先完成安裝與風險設定。
| 指標 | 月營收動能三因子(本文) | naive 加大盤擇時 | 0050 含息 |
|---|---|---|---|
| 年化報酬(CAGR) | 25.9% | 16.6% | 24.3% |
| 最大回撤(MDD) | -48.0% | -43.5% | -34.0% |
| 日夏普比率 | 0.91 | 0.70 | 1.16 |
| 月索提諾比率 | 1.67 | 1.13 | 1.92 |
| 年化波動 | 31.7% | 28.7% | 21.5% |
| 總報酬 | +624% | +273% | +547% |
| 平均持股 | 20 檔 | 20 檔 | 1 檔 ETF |
口徑:2018-01 到 2026-08(資料截至 2026-08-31,2026-10-10 重跑;策略 2018-01-31 首次建倉,0050 同日起算),策略含 finlab 預設交易成本,0050 為還原價含息買進持有(詳見文末回測方法,2026-10 的基準起算日更正也寫在那裡)。在本文設定、2018–2026 這段期間,三因子策略只有年化與總報酬贏過 0050(年化 25.9% 對 24.3%、總報酬 +624% 對 +547%);日夏普 0.91 低於 0050 的 1.16、月索提諾 1.67 低於 1.92、最大回撤 -48.0% 比 0050 的 -34.0% 深 14.0 個百分點,年化波動 31.7% 也比 0050 的 21.5% 高出約 10 個百分點。它用更大波動換取略高的絕對報酬,風險調整後並不佔優。再看中間那欄:同樣三因子,硬加上「大盤 200 日均線擇時」當作風險濾網,年化反而掉到 16.6%、月索提諾掉到 1.13,連策略本身都不如。
策略近期回落(季度重跑紀錄,數字為 2026-10-10 重跑): 與 2026-06 快照(資料截至 2026-06-09)相比,全段年化由 30.2% 降到 25.9%、月索提諾由 2.13 降到 1.67、樣本外年化由 39.2% 降到 30.3%。回落集中在最近三個月:2026-06-09 到 08-31 策略 -19.6%,同期 0050 +3.3%;近 12 個月(2025-08-29 到 2026-08-31)策略 +77.8%,也落後 0050 的 +106.5%。月索提諾 1.67 仍在 1.5 以上(FinLab 挑選範例策略時要求夏普或索提諾至少一項達到 1.5)、年化仍高於 0050,這支策略仍留作本文範例,但 2026-06 版「年化與月索提諾雙贏」的說法已不成立,改為只剩年化領先。這正是季度重跑與 Hermes 每月排程要抓的訊號:因子擁擠或市況轉向時,數字要據實下修,不調參硬撐。粗糙的大盤擇時被行情洗來洗去的代價,後面會用真數據拆解。
5 分鐘安裝路徑:Hermes、模型、finlab skill
Hermes 的官方安裝分兩條路。想要少碰命令列,用 macOS/Windows 的 Hermes Desktop installer;想跑在終端機、VPS 或 WSL2,用官方 shell installer。安裝器會處理 Python、Node.js、ripgrep、ffmpeg 等依賴,你主要要確認系統有 Git。
macOS、Linux、WSL2:
Show Code
curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash
source ~/.zshrc
hermes
Windows PowerShell:
Show Code
iex (irm https://hermes-agent.nousresearch.com/install.ps1)Hermes 能跑起來後,設定模型。官方最快路徑是:
Show Code
hermes setup --portal這個流程會開瀏覽器登入 Nous Portal、選模型,並把 web search、browser、語音與圖片等工具接好。已經有 OpenRouter、Anthropic、OpenAI-compatible endpoint 或本地模型的人,也可以用互動選單切換:
Show Code
hermes model
hermes config check
接著裝 FinLab 的 AI skill。這一份 SKILL.md 是讓 Hermes 知道怎麼抓台股資料、怎麼用 finlab 回測、怎麼避免常見前視偏差的能力包:
Show Code
npx skills add https://github.com/koreal6803/finlab-ai --skill finlab最後把 setup 提示詞交給 Hermes。首次取資料時,finlab 套件會自動引導登入,不需要把金鑰寫進提示詞或程式碼。
AI 模型怎麼選:工具調用能力優先
Hermes 可以接很多模型供應商:Nous Portal、OpenRouter、Anthropic、OpenAI、Google、DeepSeek、Qwen,也能接 Ollama、llama.cpp、vLLM、SGLang 這類自架 OpenAI-compatible endpoint。量化研究需要模型穩定讀檔、寫程式、跑終端機、修錯、整理回測結果,所以選模型時要看工具調用與長上下文,不只看一般問答分數。
| 模型路線 | 適合情境 | 優點 | 代價 |
|---|---|---|---|
| Nous Portal + Claude Sonnet 類模型 | 第一次用 Hermes、想少管 API key | 官方推薦給 agent 工作的通用選擇,工具調用穩、設定快 | 需要訂閱或用量費,資料會送到模型供應商 |
| GPT 系列高階模型 | 複雜推理、程式修錯、回測報告整理 | 推理與工具調用強,適合讓 Hermes 自己修錯迭代 | 成本通常高於小模型 |
| Gemini Pro 類模型 | 要讀很長的策略說明、報告、CSV 摘要 | 長上下文優勢明顯 | 有時需要更明確的工具使用指令 |
| DeepSeek/Qwen 大模型 | 想壓低成本,同時保留不錯的寫程式能力 | 寫 code 與改錯性價比高 | 工具調用穩定度要實測,複雜任務可能多跑幾輪 |
| 本地 Qwen 9B/14B/更大模型 | 重視隱私、想避免 API 費用、反覆實驗 | 資料不出本機,邊際成本低 | 需要硬體記憶體,速度較慢,小模型較容易漏步驟 |
| Hermes 4 | 長文研究、一般聊天、摘要 | Nous 自家開放模型,適合 chat 與推理 | 官方文件提醒它不是 Hermes Agent 內部工具迴圈的首選 |
實務上可以這樣選:第一次設定選 Nous Portal 或一個強工具調用的雲端模型;等流程跑順,再把重複、低風險的批次實驗搬到本地模型。官方本地模型文件以 Qwen3.5-9B 作為 Apple Silicon 入門例子:量化後約 5GB 模型檔,8GB 以上 unified memory 可嘗試,但長上下文與工具迴圈仍會吃記憶體。想跑 27B、35B 以上模型,通常要 32GB 以上記憶體或獨立 GPU。
本機、VPS、雲端 GPU 怎麼選
做 FinLab 回測時,Hermes 本身不一定需要昂貴 GPU。真正吃資源的是「模型推論」與「你是否要 24 小時排程」。如果模型用雲端 API,Hermes 可以跑在普通筆電或小 VPS;如果模型也要自架,本機記憶體與 GPU 才變成主要成本。
| 部署方式 | 適合誰 | 成本結構 | 優點 | 風險與限制 |
|---|---|---|---|---|
| 自己的筆電 | 學習、手動重跑、第一次設定 | 不額外買雲端機器;若用雲端模型,另有模型費 | 設定最直覺,資料檔留在自己電腦 | 筆電睡眠或關機時排程不會跑 |
| 小型 VPS | 每月固定自動重跑、手機收通知 | 官方文件舉 $5 VPS 為例,實際以雲商價格為準;模型可走 API | 穩定在線,適合 cron、Telegram/Discord 通知 | 要處理 SSH、更新、安全性與備份 |
| Serverless/Modal/Daytona | 任務不常跑,希望閒置成本低 | 依執行時間或資源計費 | 閒置時成本低,環境可重建 | 初始設定比 VPS 複雜 |
| 本機模型 | 隱私優先、反覆做低成本實驗 | 沒有模型呼叫費,但有硬體、電費與時間成本 | 策略想法與資料較少外流 | 小模型容易出錯,大模型需要記憶體或 GPU |
| 雲端 GPU | 想自架大模型、多人共用、高吞吐 | GPU 租用費高於普通 VPS | 可以跑大型開源模型與 vLLM | 對單人月度回測多半過度配置 |
如果只是每月重跑一支台股策略,最務實的配置是「小 VPS + 雲端強模型」或「自己的電腦 + 雲端強模型」。想把策略邏輯、對話、回測結果盡量留在本地,就改用本地模型,但要接受速度較慢與模型品質落差。finlab 在筆電、VPS 或雲端主機都能跑,要不要上雲端,看的是你希望 Hermes 在你離線時還能替你做多少事。
初始設定檢查表:第一次跑 FinLab 前確認
| 檢查項目 | 建議做法 |
|---|---|
| Hermes 能不能啟動 | 跑 hermes doctor 與 hermes config check,缺什麼照提示補 |
| 模型是否可用 | 跑 hermes model 選模型,再問一個簡單問題確認能回覆 |
| finlab skill 是否安裝 | 跑 npx skills add https://github.com/koreal6803/finlab-ai --skill finlab,在 Hermes 內確認 /skills 看得到 finlab |
| Python 環境 | 讓 Hermes 依 finlab skill 建環境;首次取資料用 finlab.login() 自動引導登入 |
| 資料與回測口徑 | 明講市場、股票池、交易成本、再平衡頻率、benchmark,例如 0050 含息用 etl:adj_close |
| 排程 | 用自然語言指定「每月 11 號 09:00 重跑」,並要求寫入長期記憶與輸出最新持股 |
| 安全性 | 不把金鑰寫進提示詞;若用 Telegram/Discord gateway,設定允許名單 |
Hermes Agent 是什麼?為什麼適合「養」一支量化策略
Hermes 是 Nous Research 開源的 AI Agent(MIT 授權),它和一般聊天機器人最大的差別有三點,剛好都對應「長期維護一支策略」的需求:
| 能力 | 一般聊天機器人 | Hermes Agent |
|---|---|---|
| 記憶 | 換一個對話就忘光 | 跨對話的長期記憶,記得上個月選了哪些股、衰退到什麼程度 |
| 排程 | 你不問它不動 | 內建 cron,可設定「每月 11 號自動執行」 |
| 技能沉澱 | 每次從零開始 | 把跑通的任務存成可重複呼叫的技能 |
| 標準相容 | 各家格式不一 | 支援 SKILL.md 標準,能直接讀 finlab 的技能定義 |
量化策略寫完之後還需要被「養」:每月有新營收、新股價,選股清單會換、績效會漂移,因子也可能擁擠失效。傳統做法是你手動每月開電腦重跑、自己記得上個月的結果、自己判斷有沒有衰退。Hermes 把這三件雜事自動化,等於替你的策略請了一個會記事、會定時、會累積經驗的研究助理。想先補齊量化交易的整體脈絡,可以讀量化交易完整指南;對 AI Agent 怎麼跑回測還沒概念,AI Agent 量化交易實戰有從零開始的三段對話示範;想比較 Hermes 與 Claude Code、Codex、Pi、龍蝦各自的強項與適用情境,見 AI Agent 量化交易工具比較。
策略本體:月營收成長動能三因子
策略的核心是三個低相關的因子,疊在一個「健康成長」的股票池上:
- 營收成長:台股強制公布月營收,這是全球少數的月頻基本面資料。我們取營收年增率的全市場百分位排名。
- 價格動能:用近 60 個交易日(約一季)報酬的全市場排名,捕捉市場已經在追的標的。
- 品質(ROE):用稅後 ROE 的排名,避免買到「營收衝但賺不到錢」的公司。
健康成長池的定義是:營收年增介於 10% 到 200%(排除衰退股,也排除基期過低的暴衝),且最近 3 個月都正成長。三個因子都在「近 20 日平均成交金額大於 1,000 萬」的股票裡做排名,排名相加當綜合分數,再從健康成長池挑分數最高的 20 檔,分數平方加權、每月再平衡。下面是頁面內可直接讀的核心程式碼,每一段對應一個動作:
Show Code
import finlab
from finlab import data
from finlab.backtest import sim

# 首次取資料時 finlab 會自動引導登入
finlab.login()

# 1) 載入資料
close = data.get("price:收盤價")
volume = data.get("price:成交股數")
revenue_yoy = data.get("monthly_revenue:去年同月增減(%)").reindex(close.index, method="ffill")
roe = data.get("fundamental_features:ROE稅後").index_str_to_date()
roe = roe.reindex(close.index, method="ffill")

# 2) 流動性:近 20 日平均成交金額大於 1,000 萬
liquid = ((close * volume).rolling(20).mean() > 10_000_000) & close.notna()

# 3) 健康成長池:年增 10%~200%,且最近 3 個月都正成長
healthy_growth = (
    (revenue_yoy > 10)
    & (revenue_yoy < 200)
    & ((revenue_yoy > 0).rolling(3).sum() == 3)
)

# 4) 三個因子各自在流動性合格的股票裡做百分位排名,相加為綜合分數
def rank_pct(factor):
    return factor.where(liquid).rank(axis=1, pct=True)

score = rank_pct(revenue_yoy) + rank_pct(close.pct_change(60)) + rank_pct(roe)

# 5) 在健康成長池內取前 20 名,分數平方加權
top20 = score.where(healthy_growth).rank(axis=1, ascending=False) <= 20
weight = score.where(top20, 0) ** 2
weight = weight.div(weight.sum(axis=1), axis=0).fillna(0)

# 6) 2018 年起每月再平衡回測
report = sim(weight[weight.index >= "2018-01-01"], resample="M", name="月營收成長動能")
report.display()
平方加權的用意是讓綜合分數最高的股票拿到更高權重,20 檔不齊頭等權;後面的敏感度段把它和等權版放在一起比。文末可下載的完整版本多了資料截止日設定與績效統計,執行後會印出本文績效表與敏感度表的數字(年化、夏普、索提諾、最大回撤、年化波動、總報酬、平均持股、月周轉率,含同窗 0050、naive 對照與樣本外),並列出資料截止日的持股權重;區間報酬可用附的 data.csv 自行計算。
Hermes 的招牌用法:每月自動重跑、寫進長期記憶
策略寫好只是起點。台股月營收約每月 10 號公布,Hermes 的價值是接手後續所有重複工作。下面這段提示詞就是把整個維護迴圈交給它(複製即用):
每月 11 號自動重跑這支月營收成長動能策略,把這個月的選股清單跟上個月
比對,並把「哪些股票被換掉、整體績效有沒有衰退」記到長期記憶。
實際對話會像這樣:
💬 你對 Hermes 說:
每月 11 號自動重跑這支月營收成長動能策略,把這個月的選股清單跟上個月比對,並把「哪些股票被換掉、整體績效有沒有衰退」記到長期記憶。
🤖 Hermes 回覆:
已建立排程:每月 11 號 09:00 觸發。剛才先跑了一次當基準:全段年化 25.9%、月索提諾 1.67,仍在 1.5 的門檻之上;但最近三個月(2026-06-09 到 08-31)策略 -19.6%,同期 0050 +3.3%,近 12 個月(2025-08-29 到 2026-08-31)+77.8% 也落後 0050 的 +106.5%,已標記為「連續回落,觀察中」。已把本月前 20 名清單、與上月的差異和滾動績效寫入長期記憶
revenue_momentum_strategy,下個月會自動跟這份基準比較。
這裡發揮了 Hermes 的三項特長:cron 負責「每月 11 號自動觸發」,長期記憶負責「記得上月清單與績效當基準」,技能沉澱讓「重跑—比對—記錄」這串動作存成一個可重複呼叫的技能,下個月不必重新交代。對比 AI 選股提示詞與真實回測 那種一次性問答,這裡的重點是把策略當成需要長期照顧的系統,每個月自動重跑、比對、留紀錄。
提醒:上面的回覆是示意對話,用來說明 Hermes 的記憶與排程怎麼運作;引文中的績效數字取自本文 metrics.json 與 data.csv,你自己跑
strategy.py時以當日輸出為準。
為什麼要 walk-forward?樣本外才是真考試
一支策略在它「被設計的那段歷史」上表現好,幾乎是必然的,因為你(或 AI)是看著那段資料調出來的。要判斷它有沒有真本事,得看它在沒見過的資料上的表現。walk-forward 的做法很單純:把歷史切成兩段,前段當研究段(in-sample)、後段當樣本外(out-of-sample),分開計算績效。如果樣本外明顯崩掉,就是過擬合的警訊。關於回測本身的方法論與常見陷阱,可延伸讀什麼是回測。
把這個檢查也交給 Hermes,提示詞如下:
用 2018-2021 當研究段、2022 年之後當樣本外,分開算績效,
告訴我這支策略在沒見過的資料上有沒有失效。
我們真的這樣切了:研究段是 2018–2021,樣本外是 2022 年初到 2026-08。結果分兩層看。只看策略自己,樣本外沒有崩塌,年化與月索提諾都高於全段;把同一段的 0050 含息放在旁邊,策略年化只多 0.7 個百分點,日夏普、索提諾與最大回撤全部落後:
| 指標 | 策略全段 2018–2026 | 0050 含息全段 | 策略樣本外 2022–2026 | 0050 含息樣本外 |
|---|---|---|---|---|
| 年化報酬 | 25.9% | 24.3% | 30.3% | 29.6% |
| 日夏普比率 | 0.91 | 1.16 | 1.01 | 1.25 |
| 日索提諾 | 1.24 | 1.59 | 1.39 | 1.77 |
| 月索提諾 | 1.67 | 1.92 | 2.06 | 2.39 |
| 最大回撤(MDD) | -48.0% | -34.0% | -42.6% | -34.0% |
| 總報酬 | +624% | +547% | +243% | +235% |
粗體標示樣本外兩欄中較好的一方。全段從 2018-01-31 起算,樣本外兩欄都從 2022-01-03 起算。
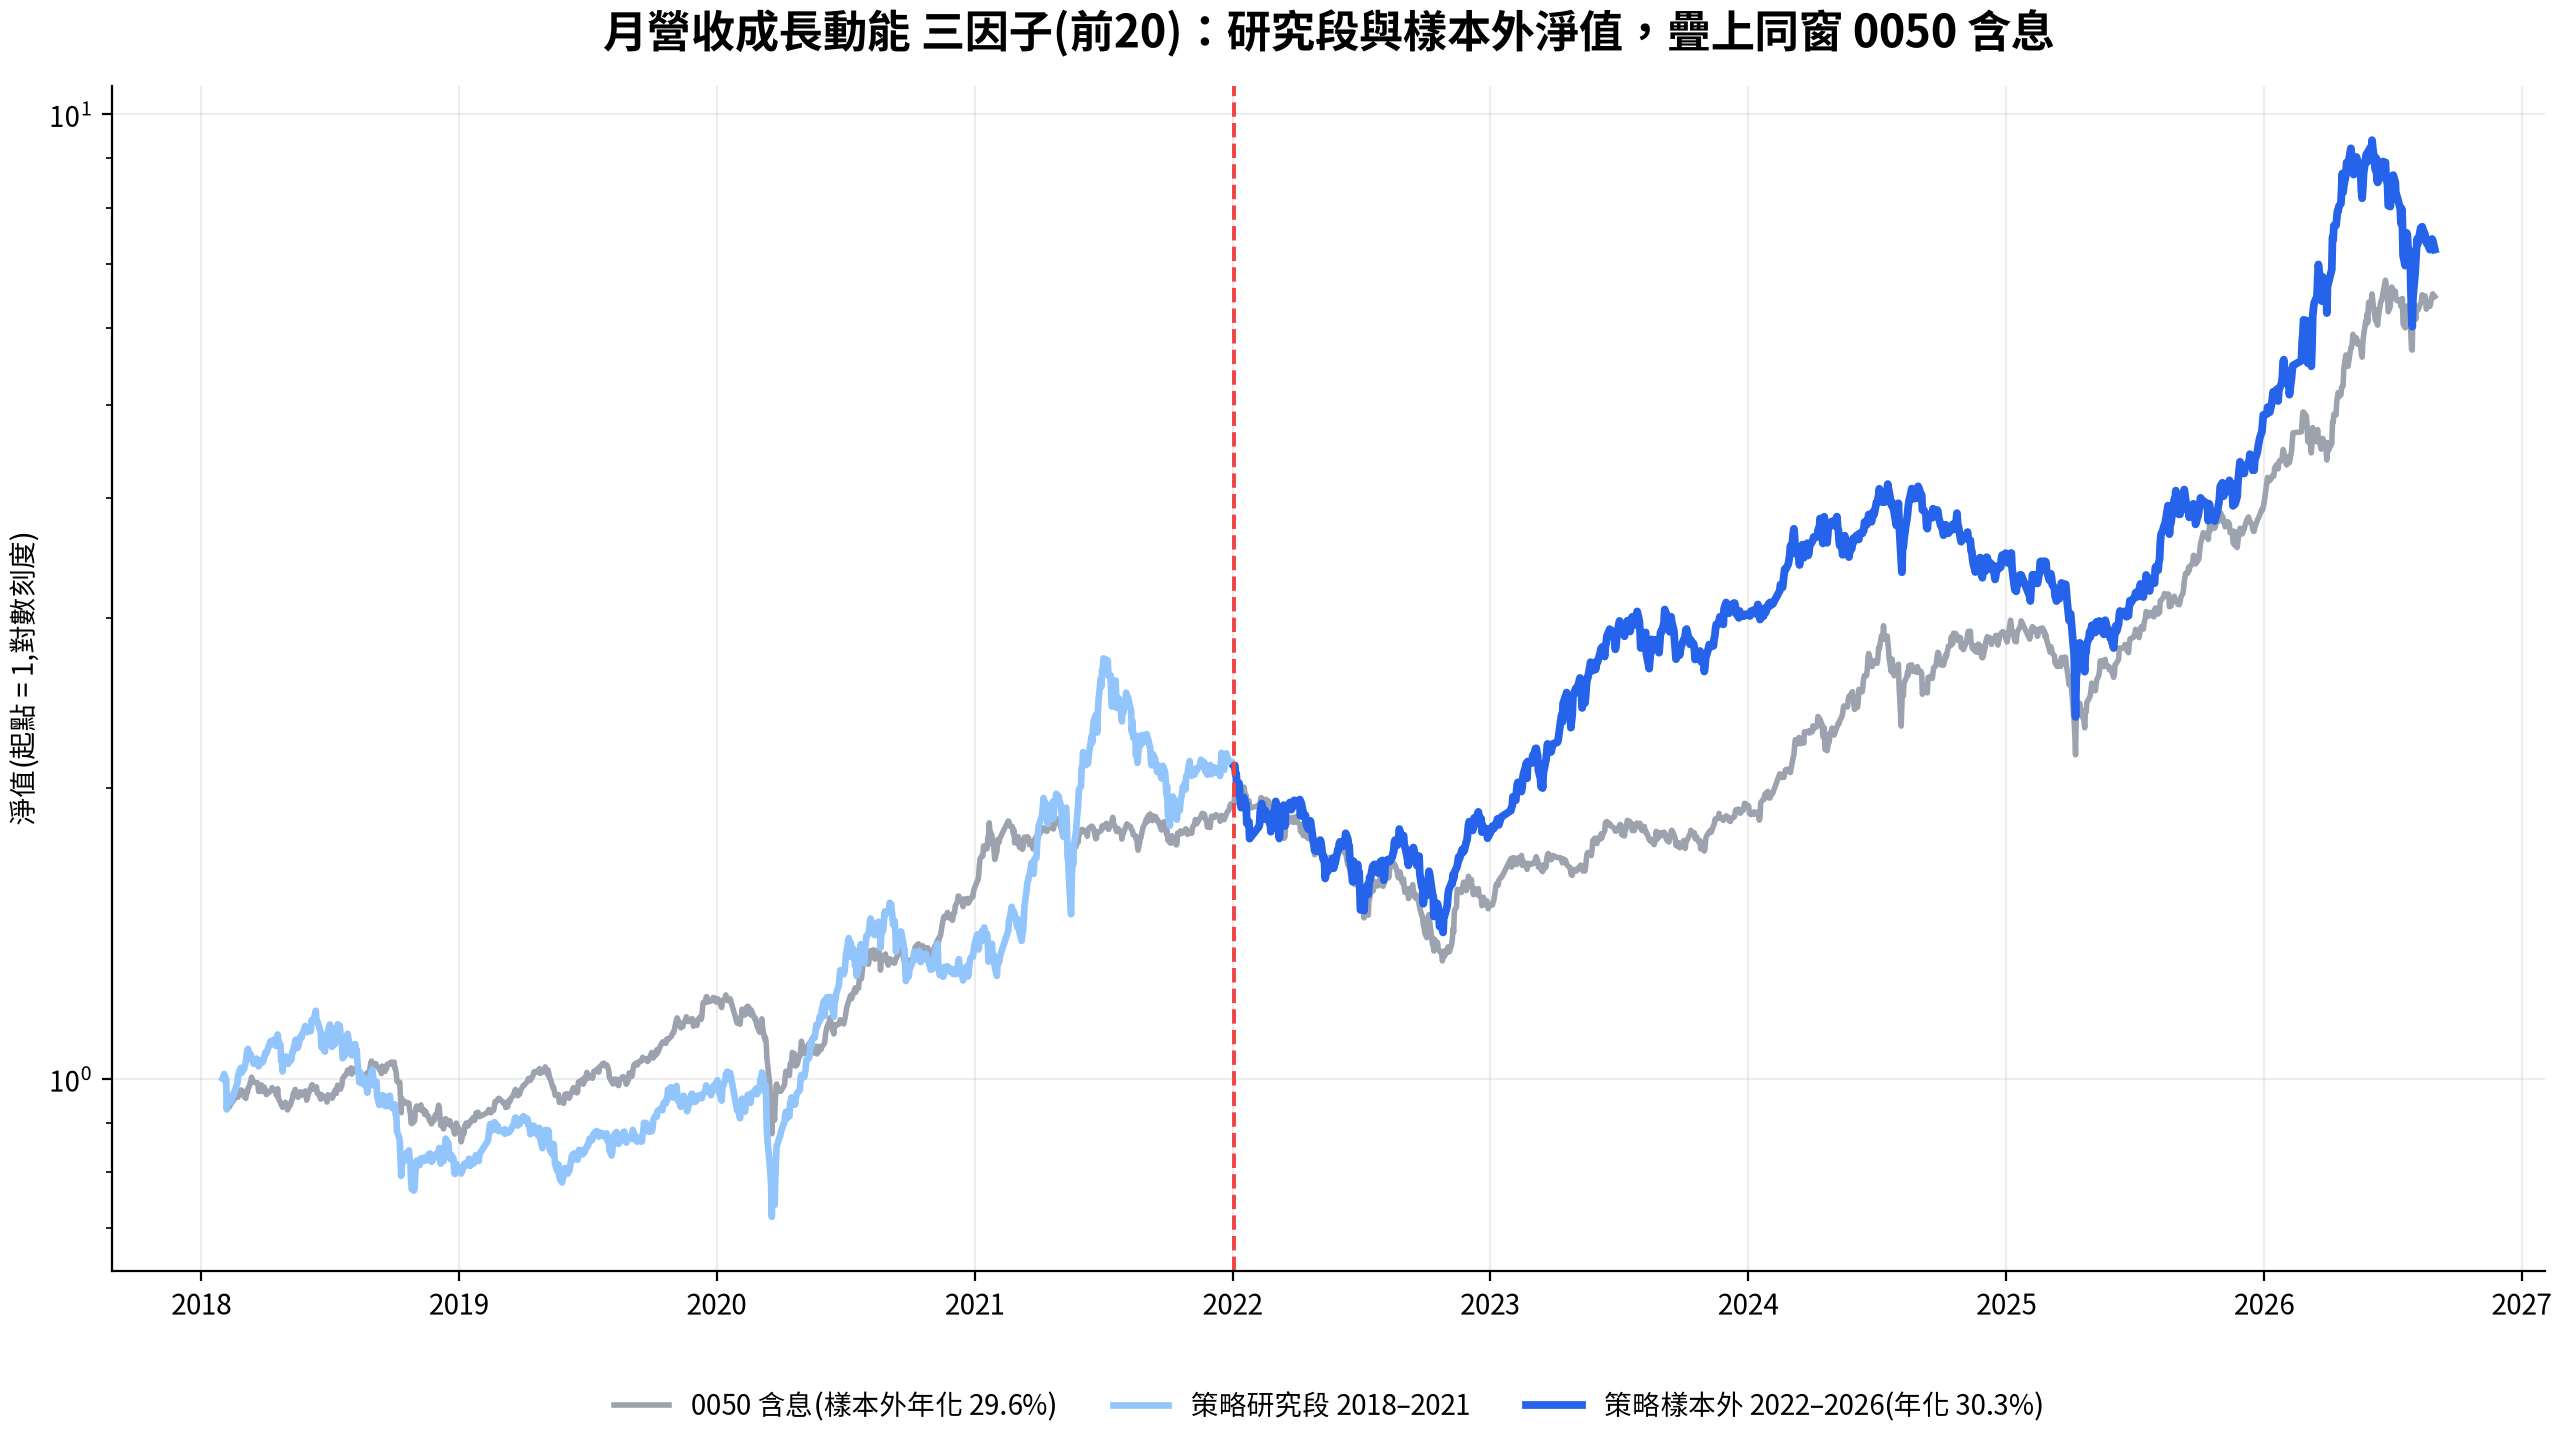
樣本外段策略年化 30.3%、月索提諾 2.06,都比它自己的全段數字好,策略邏輯(健康成長 + 動能 + 品質)在 2022 升息修正與之後的行情裡沒有出現過擬合式的崩塌。可是同一段 0050 含息年化 29.6%、月索提諾 2.39、最大回撤 -34.0%:策略只在年化上多 0.7 個百分點,承擔的回撤卻深了 8.6 個百分點。2022 之後台股是一段強勢電子行情,對營收動能因子有利,也同樣推升了權值股集中的 0050。所以這次 walk-forward 能支持的結論只到「沒有過擬合崩塌」為止,樣本外並沒有出現打敗大盤的證據;2026 年 6 月到 8 月的回落也把樣本外年化從 2026-06 版的 39.2% 拉到 30.3%。
還有一個限制要講清楚:這支策略的因子與門檻是在 2026-06 首次發佈時定下的,當時 2018 到 2026 的全段資料都已存在,無法證明 2022 之後的行情完全沒有影響設計,所以這裡的切分是時間切分檢查,嚴格意義上沒參與設計的前瞻樣本,是首次發佈日 2026-06-22 之後的區間:到 2026-08-31,策略 -18.8%、0050 含息 -3.8%。兩個多月太短,不足以下結論,季度重跑會繼續累積。完整互動式回測報告(月報酬熱力圖、年度績效、權益曲線都在裡面):
naive 的教訓:粗糙的大盤擇時反而傷績效
很多人看到 -48.0% 的回撤,第一反應是「加個大盤濾網閃開崩盤不就好了」。我們把這個直覺也跑成真數據:同樣三因子,加上「只有大盤站上 200 日均線才進場、跌破就空手」的擇時規則,結果反而更差。
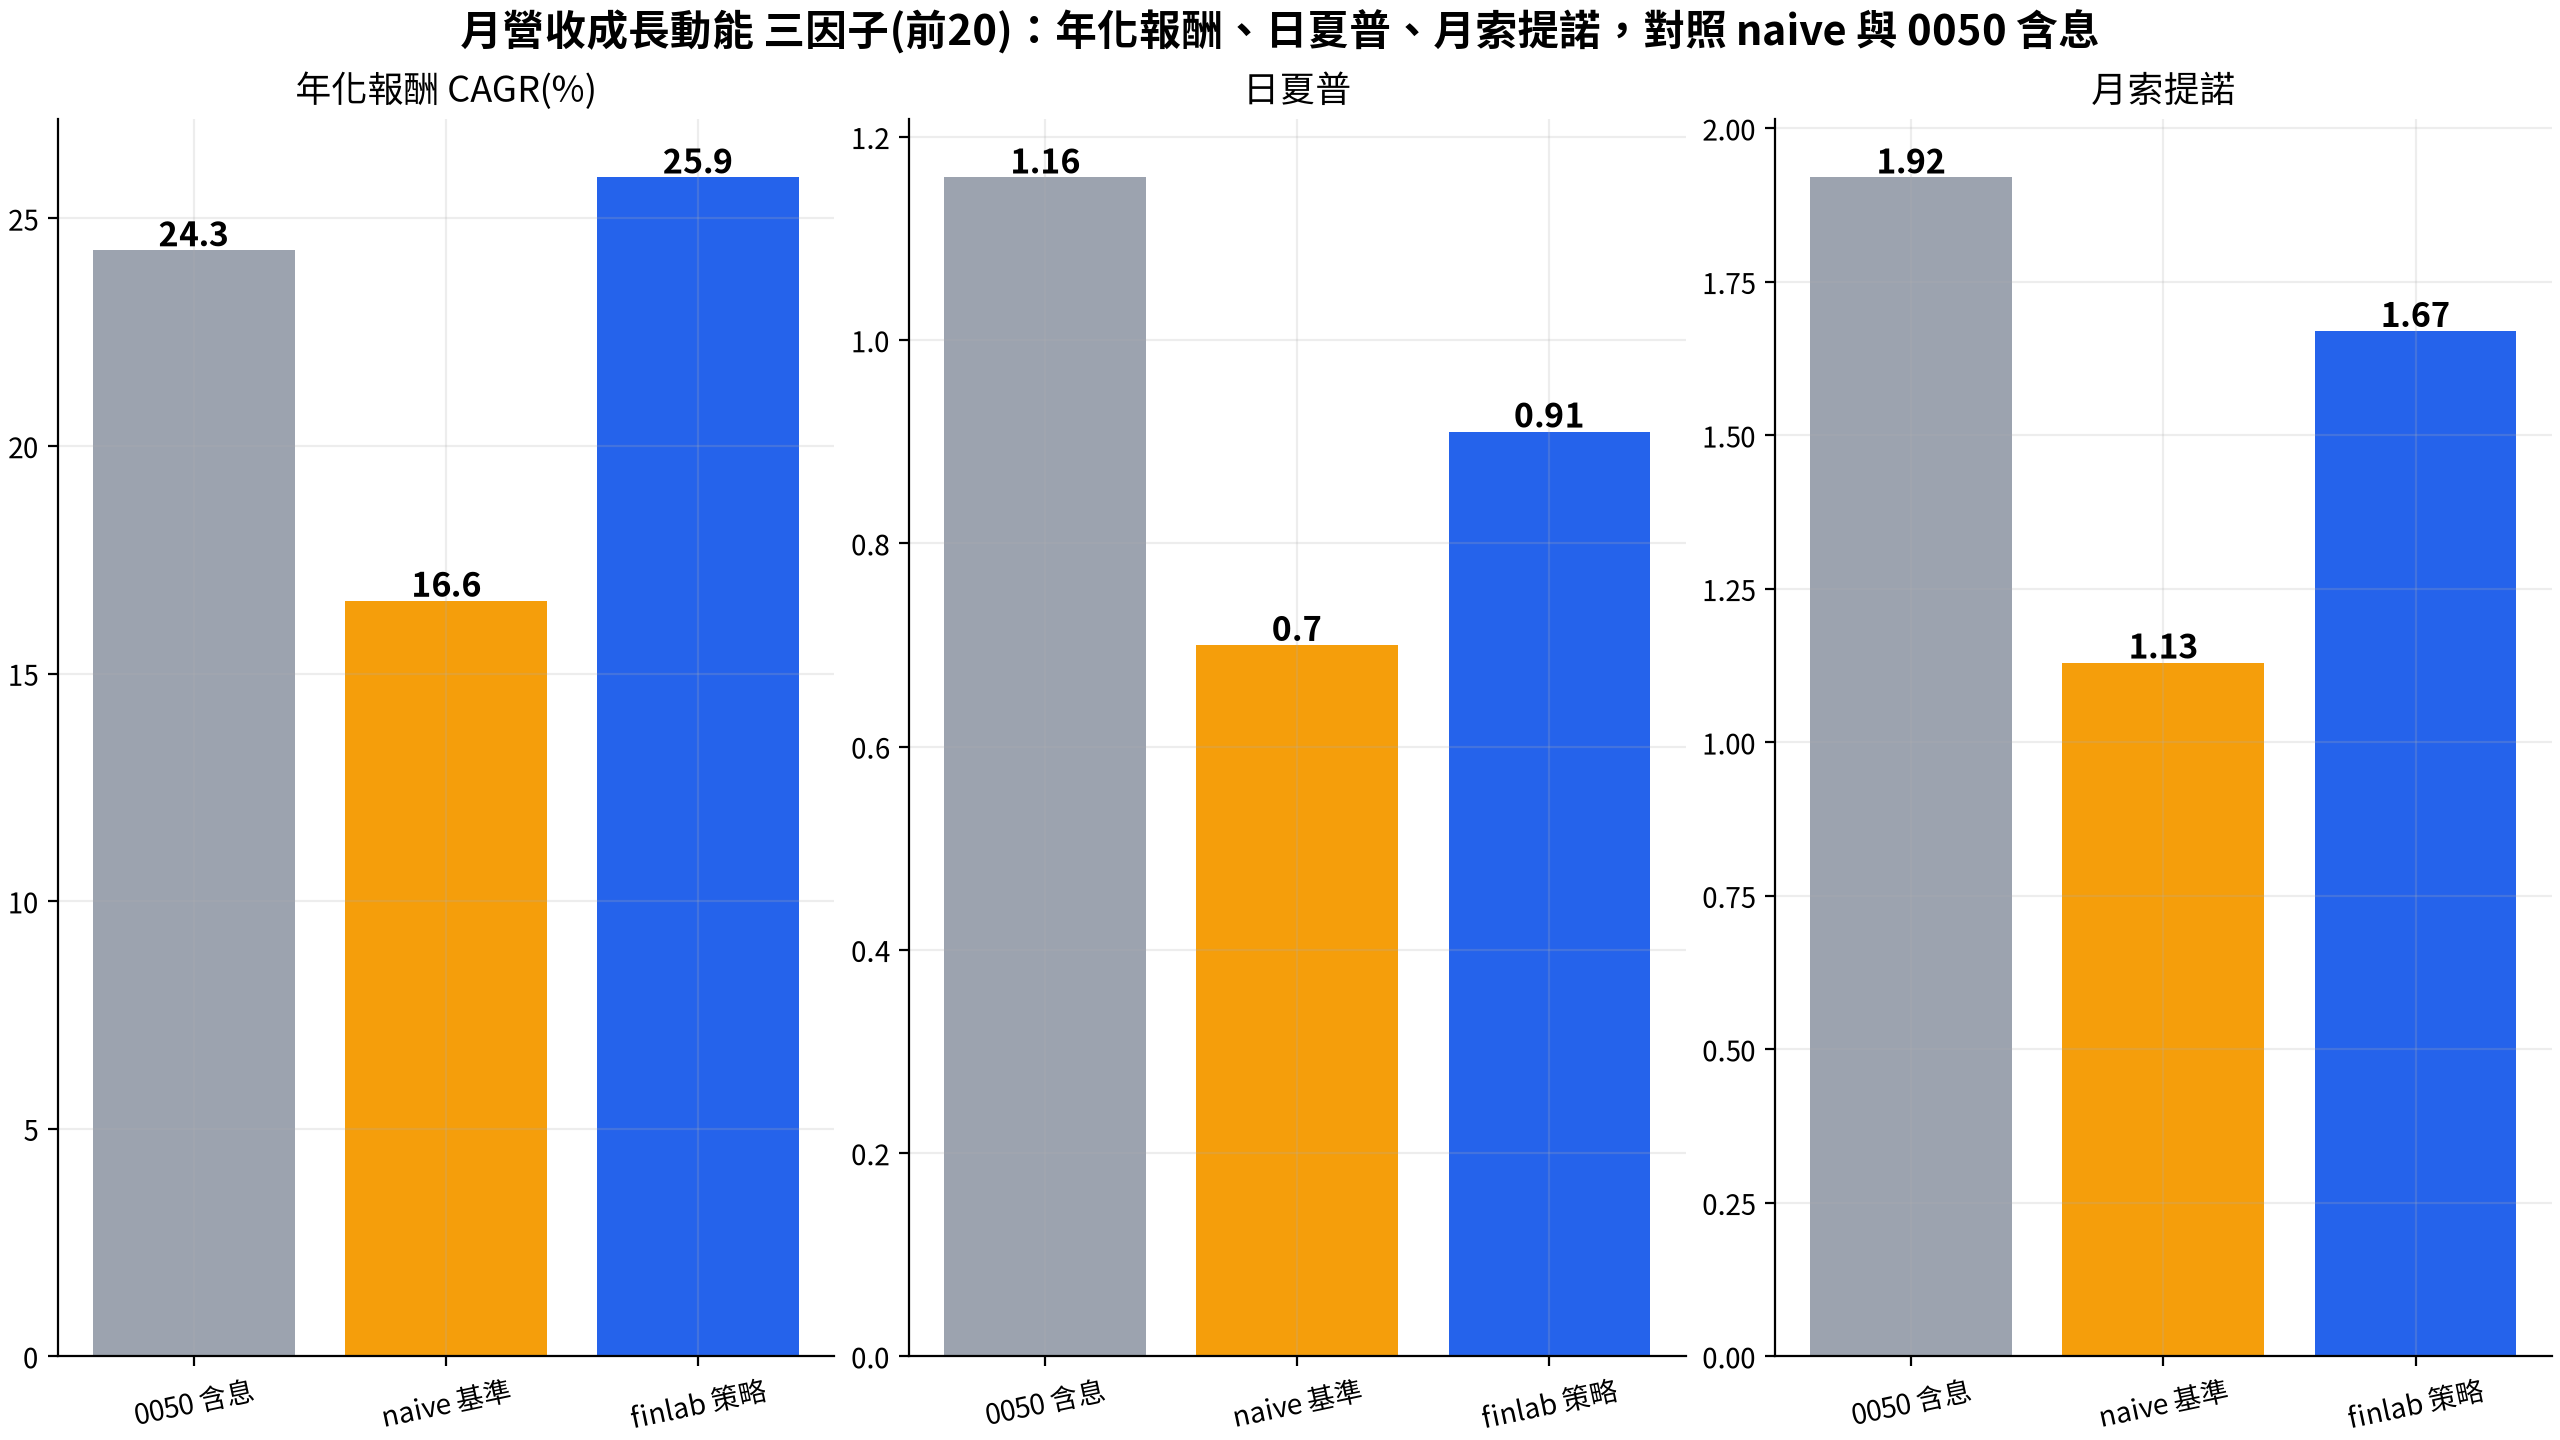
| 指標 | 三因子原始 | 加大盤 200MA 擇時 | 差異 |
|---|---|---|---|
| 年化報酬 | 25.9% | 16.6% | -9.3 個百分點 |
| 月索提諾 | 1.67 | 1.13 | 變差 |
| 最大回撤 | -48.0% | -43.5% | 淺 4.5 個百分點 |
| 總報酬 | +624% | +273% | 少了五成多 |
加擇時讓最大回撤從 -48.0% 變成 -43.5%,只淺了 4.5 個百分點,代價卻是年化少了 9.3 個百分點、總報酬少了五成多。拆開幾段大跌看得更清楚:2022 年擇時版確實少跌(年內最深 -18.6%,原始版 -32.9%);2020 年 3 月疫情急跌,從 1 月中的高點算起兩版一樣跌了 29.3%,均線訊號來不及反應;2018 年那一段擇時版反而更深,從 2018-04 高點一路回落,直到 2020-03 都沒回到前高,全期最大回撤就出在這段。
代價主要來自錯過反彈,交易成本不是主因:擇時版的平均月周轉率 48%,還低於原始版的 59%。擇時只在每月再平衡日判斷,回測期間一共空手 7 段,每段都從月初開始;這 7 段裡原始策略全部上漲,例如 2020 年 4 月 +14.5%、2023 年 11 月 +16.1%,2022 年 5 月到 2023 年 1 月空手 9 個月,躲過了原始策略 5 月到 10 月底 -17.6% 的跌勢,也錯過之後到 2023 年 1 月 +34.8% 的反彈,整段下來原始策略仍是 +11.1%。200 日均線這種粗糙訊號在盤整與假突破時會被「洗來洗去」,常常空手在低點、回到市場時反彈已經走了一段。這正是把這個教訓寫進 Hermes 長期記憶的價值,提示詞如下:
我之前試過加大盤 200 日均線擇時,實測月索提諾從 1.67 掉到 1.13,
以後別再幫我加這個濾網。
把失敗的實驗也記下來,Hermes 下次優化策略時就不會重蹈覆轍,也不會在你忘記時又把這個壞濾網加回來。下檔保護的取捨向來不簡單,類似結論在 ATR 移動停損的台股實測 也出現過:多數設定下,停損與大盤濾網反而傷害長期報酬。
回測方法與限制
這些數字是怎麼算出來的,逐項交代:
| 項目 | 本文設定 |
|---|---|
| 回測區間 | 2018-01 到 2026-08(資料截至 2026-08-31,2026-10-10 重跑,finlab 2.2.8);策略 2018-01-31 首次建倉;walk-forward 研究段 2018–2021、樣本外 2022-01-03 起 |
| 交易成本 | finlab sim() 台股預設值:手續費 0.1425%(未打折)、賣出證交稅 0.3%,已內扣 |
| 滑價 | 未另行假設;實際衝擊取決於資金規模與個股成交量,本文未估算策略容量 |
| 股票池 | 全上市櫃,finlab 資料含已下市股票,無生存者偏誤;未刻意排除金融股與 KY 股;ETF 因無月營收與 ROE 資料自然不會入選 |
| 流動性過濾 | 近 20 日平均成交金額大於 1,000 萬 |
| 前視偏差 | 月營收用「去年同月增減」依公布時點向後填值到日頻;ROE 用 index_str_to_date 對齊財報公布日;動能只用已實現收盤價報酬 |
| 權重 | 綜合分數平方加權,每月再平衡;naive 擇時版同為平方加權,0050 還原價低於 200 日均線時整月空手(只在每月再平衡日判斷);未設單檔上限,資料截止日單檔權重約 4.5% 到 5.6%;敏感度另跑前 20 等權版 |
| 周轉率 | 平均月周轉率 59%(單邊換手,最高單月 90%),naive 擇時版平均 48%;高周轉是本策略成本的主要來源,手續費與證交稅已內扣在績效中 |
| 樣本內外 | 有做 walk-forward:研究段 2018–2021、樣本外 2022–2026 分開計算;參數於 2026-06 設計時全段資料已存在,2022 之後屬時間切分檢查,嚴格的前瞻樣本是首次發佈日之後。首次發佈日 2026-06-22 到 2026-08-31:策略 -18.8%、naive 擇時版 -18.8%、0050 含息 -3.8%,樣本只有兩個多月,只作紀錄;敏感度用的是全段,屬穩健性參考 |
| 0050 基準 | etl:adj_close 還原價含息買進持有,純指數算術、不含交易成本,與策略同一天(2018-01-31)起算;基準不扣成本而策略扣,比較口徑對策略偏保守 |
2026-10 重跑與基準更正: 2026-10-10 以同一個資料截止日(2026-08-31)重跑全部數字,修正三件事。第一,0050 基準原本從 2018-01-02 起算,比策略首次建倉的 2018-01-31 早了一個月,兩條曲線不在同一個視窗;改為同一天起算後,0050 年化由 24.8% 修正為 24.3%、日夏普由 1.18 修正為 1.16、總報酬由 +580% 修正為 +547%,walk-forward 表也補上同窗 0050 欄位。第二,頁面內與可下載的程式碼原本在健康成長池內排名、沒有流動性過濾,和產生本文數字的回測引擎不一致,跑不出文中數字;現在兩者都改成引擎的同一套邏輯,strategy.py 執行後逐格對得上本文表格。第三,重跑後策略年化由 2026-09 版的 26.5% 變成 25.9%、最大回撤由 -46.8% 變成 -48.0%,樣本外年化由 29.7% 變成 30.3%,naive 擇時版最大回撤由 -45.8% 變成 -43.5%(「擇時只少 1.0 個百分點回撤」因此改為 4.5 個百分點)。回測引擎的選股邏輯沒有改動,這類重跑差異可能來自 finlab 歷史資料修補或套件版本更新(本次使用 finlab 2.2.8),本文無法逐項拆解;最近三個月與近 12 個月的區間報酬則完全相同。另外新增前 20 等權的敏感度列。
敏感度:持股數與加權方式,結論對持股數敏感
平方加權與「前 20 檔」都是設計選擇,會不會剛好挑到漂亮參數?我們另跑三組:前 20 改等權、持股數放寬到 30 與 40 檔(後兩者維持平方加權)。四組的日夏普(0.88 到 0.91)與月索提諾(1.48 到 1.67)都低於 0050 的 1.16 與 1.92,年化只有前 20 檔的兩個版本高於 0050 的 24.3%:
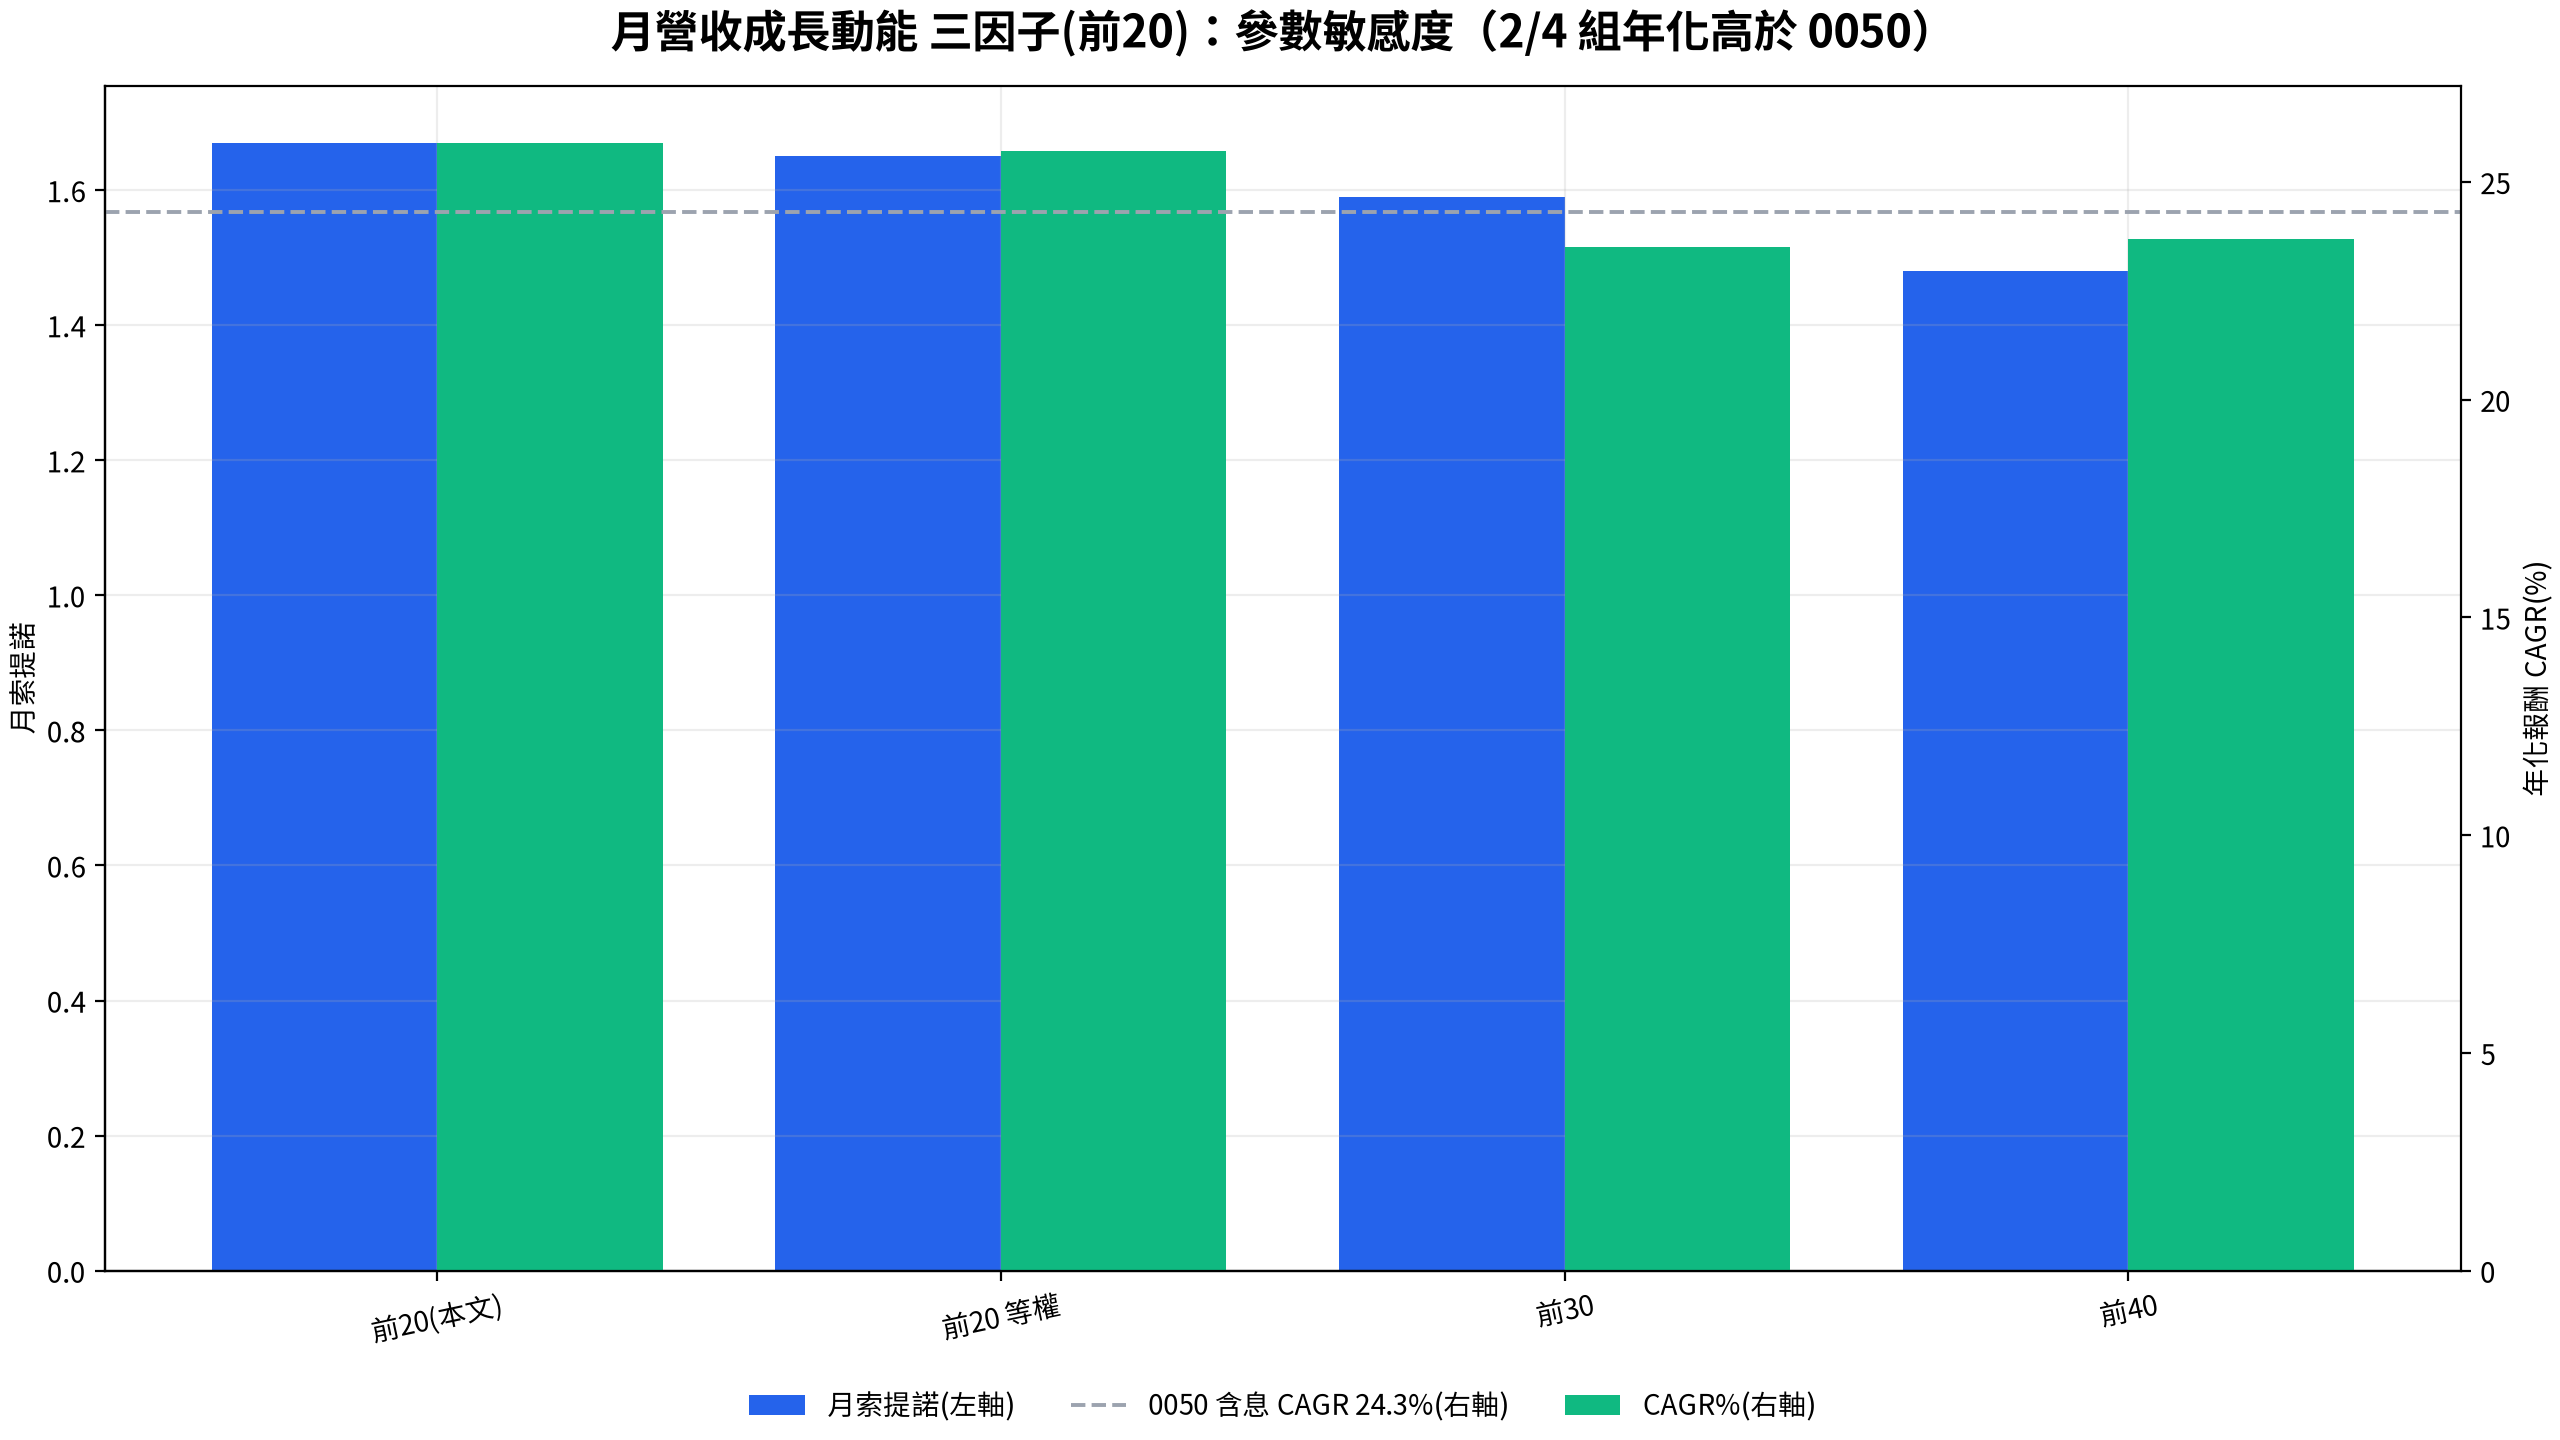
| 設定 | 年化報酬 | 最大回撤 | 日夏普 | 月索提諾 |
|---|---|---|---|---|
| 前 20 平方加權(本文採用) | 25.9% | -48.0% | 0.91 | 1.67 |
| 前 20 等權 | 25.7% | -47.9% | 0.91 | 1.65 |
| 前 30 平方加權 | 23.5% | -46.9% | 0.88 | 1.59 |
| 前 40 平方加權 | 23.7% | -44.3% | 0.91 | 1.48 |
可以看到三件事。第一,平方加權和等權幾乎沒有差別(年化 25.9% 對 25.7%、月索提諾 1.67 對 1.65),報酬來自選進來的 20 檔本身,加權方式是次要細節。第二,持股從 20 檔放寬到 30 檔,年化由 25.9% 掉到 23.5%,放寬到 40 檔是 23.7%,都低於同期 0050 的 24.3%;2026-06 快照時持股數三組都贏 0050,季度重跑後結論對持股數變得敏感,等於「贏過 0050」這件事只在最集中的 20 檔版本成立。第三,持股越多回撤略淺(-48.0%、-46.9%、-44.3%),但最淺的前 40 檔仍比 0050 的 -34.0% 深 10 個百分點以上,分散在這組因子上換不到多少下檔保護。敏感度表的用途是確認結論穩健,回頭挑出最漂亮的那一格當主角就失去意義;這次它告訴我們的是結論不夠穩健。把回撤的完整時間軌跡攤開看:
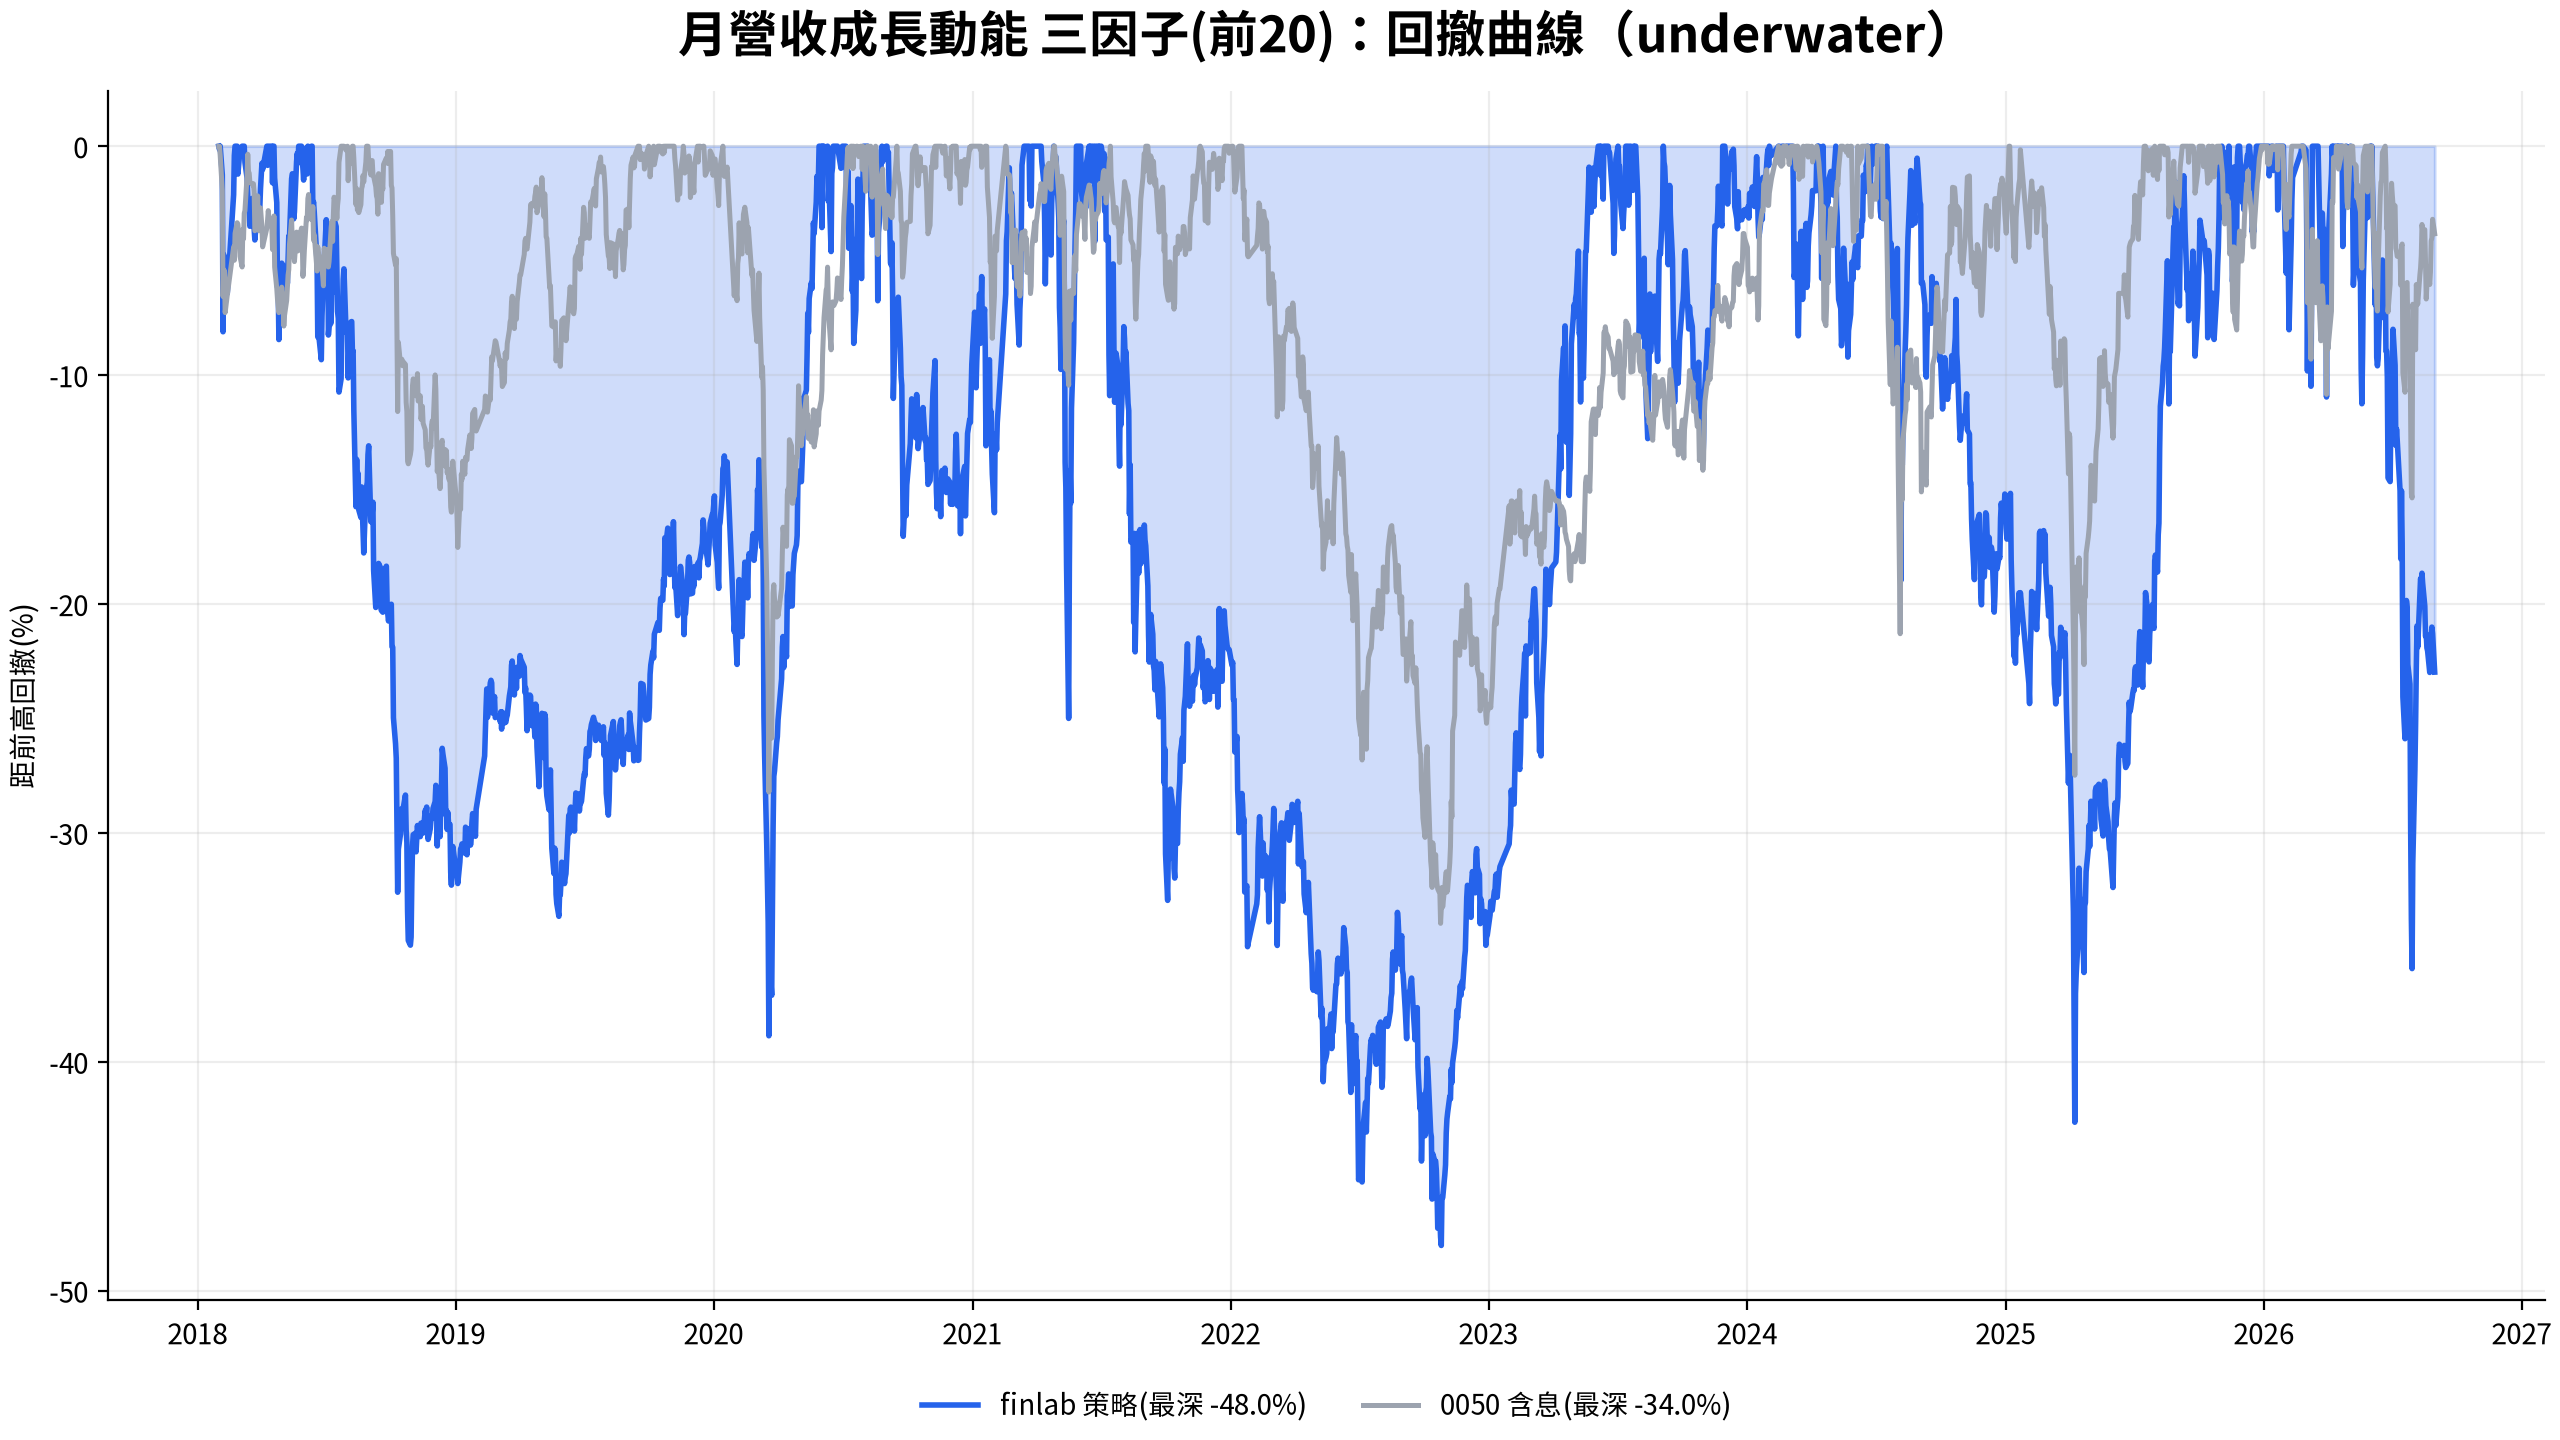
回撤曲線把「波動換報酬」的代價畫得很清楚。2018 年那段,策略從 6 月高點跌到 10 月底,回撤 -34.9%,0050 在 2018 年 8 月到 2019 年 1 月初那一段最深 -17.5%;全期最深的一段從 2021 年 7 月高點跌到 2022 年 10 月升息修正的低點,-48.0%,0050 從 2022 年 1 月高點起算最深 -34.0%;2024 年 7 月高點到 2025 年 4 月急跌的低點,策略 -42.6%(這也是樣本外段的最大回撤),0050 從 2025 年 1 月高點起算 -27.5%;2026 年 6 月到 7 月底的回落也已見到 -35.9%,0050 同期最深 -15.4%。換算成金額,100 萬一度會縮水到約 52 萬。能不能撐過這種帳面腰斬而不停損,是決定你最後拿不拿得到那條淨值曲線的關鍵。
三個因子背後的學術研究
這支策略的三個因子,各自對應行之有年的實證發現:
- 價格動能:Jegadeesh & Titman (1993) 發現過去 3 到 12 個月的贏家股票,後續數月平均持續跑贏輸家,動能成為實證金融最廣被複製的異常報酬之一。本文用 60 個交易日報酬當動能指標。
- 獲利品質:Novy-Marx (2013) 證明獲利能力強的公司即使估值不便宜,長期報酬仍系統性較高。他用毛利對資產,本文用 ROE,同屬獲利能力家族但口徑不同,效果不能直接劃等號。
- 盈餘與動能的關聯:Chan, Jegadeesh & Lakonishok (1996) 發現價格動能與盈餘相關訊息(如盈餘驚奇)彼此獨立、又能相互補強,把基本面成長與價格動能合用比單押其一更穩健,是本文「營收 + 動能」組合最接近的學術依據;但該研究的基本面訊號是盈餘,本文改用月營收年增,屬於延伸應用,效果不能直接沿用。
要補充一個常見的引用誤區:有些文章會把 Bernard & Thomas (1989) 的「盈餘公告後漂移」(PEAD)拿來支撐「對齊月營收公布日」。但 PEAD 講的是季度盈餘公告後的價格漂移,月營收是另一回事,它是領先指標、頻率更高、也不等於盈餘。本文用月營收是看中它「比季報早一步反映成長加速」的資料優勢,這個機制需要單獨論證,不能沿用 PEAD 的結論。把不同因子用排名合成的整體效益,多因子選股能不能贏 0050 的實測 有另一組獨立驗證。
適合誰、不適合誰
適合:
- 能承受帳面接近腰斬(最深 -48.0%)、追求長期複利的投資人。
- 想用 AI Agent 把「每月重跑、比對、記錄」自動化,不想每月手動維護策略的人。
- 重視可重現研究的人:本文全部數字附程式碼與資料,能自己跑一次驗證。
不適合:
- 把它當低風險替代品的人:它的日夏普 0.91 低於 0050 的 1.16,回撤更深。
- 期待「加個濾網就能閃崩盤」的人:naive 段已證明粗糙擇時反而傷績效。
- 資金規模大到單筆買賣會推動股價的人:策略持股偏中小型成長股,容量有限,本文未估算容量上限。
和一般股票看盤軟體相比,這套流程的差別在於它能跟 AI 對話、免自己寫程式,而且台股月營收、財報、價格資料齊全,回測自帶交易成本。市面上各種台股回測工具的完整比較,見台股回測工具怎麼選;想用 AI 系統性地挖因子,可參考 AI 因子探勘 Agent 與 AI 量化研究流程。
常見問題
Hermes Agent 是什麼?和 Claude、ChatGPT 有什麼不同?
Hermes 是 Nous Research 開源的 AI Agent(MIT 授權),最大特色是跨對話的長期記憶、內建 cron 排程,以及能把任務沉澱成可重複呼叫的技能。一般聊天機器人換個對話就忘光、也不會自己定時執行;Hermes 適合「需要被長期照顧」的工作,例如每月重跑一支策略並記住歷史結果。它支援 SKILL.md 標準,所以能直接讀 finlab 的技能定義。
Hermes Agent 最快怎麼安裝?
macOS/Windows 新手用 Hermes Desktop installer 最快,裝完開 Hermes 即可;命令列使用者在 macOS、Linux、WSL2 跑 curl -fsSL https://hermes-agent.nousresearch.com/install.sh | bash。安裝完成後跑 hermes setup --portal 選模型,再用 npx skills add https://github.com/koreal6803/finlab-ai --skill finlab 裝 FinLab skill。這三步完成,Hermes 就能接上 finlab 回測。
Hermes 做 FinLab 量化研究該用哪個 AI 模型?
第一次設定用雲端強模型比較穩,優先看工具調用、長上下文與修錯能力。Claude Sonnet 類模型適合一般 agent 工作,GPT 高階模型適合複雜推理與程式修錯,Gemini Pro 類模型適合長文件與大段報告,DeepSeek/Qwen 大模型適合壓低成本。本地小模型適合重複實驗與隱私需求,但要接受速度與穩定度落差。Hermes 4 適合聊天與研究摘要,官方文件提醒它不是 Hermes Agent 工具迴圈的首選。
一定要買雲端主機或 GPU 嗎?
不用。Hermes 用雲端 API 模型時,普通筆電就能跑;如果要每月自動重跑、不想依賴筆電開機,租一台小型 VPS 更穩。雲端 GPU 只有在你要自架大型開源模型、多人共用或高吞吐時才比較合理。單人每月重跑台股策略,多數情境用「本機或小 VPS + 雲端模型」就夠了。
可以完全在本地端跑 Hermes 和模型嗎?
可以,但硬體要跟任務匹配。Hermes 可以接 llama.cpp、Ollama、MLX、vLLM、SGLang 等 OpenAI-compatible endpoint;Apple Silicon 入門可嘗試量化後的 Qwen 9B 等小模型,16GB 記憶體會比 8GB 餘裕得多。若要長上下文、複雜程式修錯或大型模型,32GB 以上記憶體或 GPU 會比較實際。本地端的優點是資料較少外流、沒有模型呼叫費;缺點是速度慢、模型品質較不穩,排程也依賴你的機器保持運作。
為什麼要 walk-forward?整段一起回測不行嗎?
整段一起回測(全段 in-sample)的問題是:你或 AI 是看著那段歷史調策略的,表現好幾乎是必然。walk-forward 把歷史切成研究段與樣本外,只看策略在沒見過的資料上的表現。本文研究段 2018–2021、樣本外 2022–2026,樣本外年化 30.3%、月索提諾 2.06,都比全段好,沒有過擬合式的崩塌;但同一段 0050 含息年化 29.6%、月索提諾 2.39,策略在樣本外只是打平大盤年化,風險調整後落後。2026 年 6 到 8 月的回落也把樣本外年化從 2026-06 版的 39.2% 拉低到 30.3%。另外,參數設計時全段資料已存在,這裡的切分屬時間切分檢查,嚴格的前瞻樣本是首次發佈日 2026-06-22 之後。樣本外好不等於未來保證好,2022 之後的強勢電子行情剛好對營收動能有利,要把這點納入解讀。
加大盤均線擇時不是能避開崩盤嗎?為什麼反而變差?
理論上可以,實測上常常不行。本文把同三因子加上「大盤站上 200 日均線才進場」的規則,年化從 25.9% 掉到 16.6%、總報酬少了五成多,最大回撤只從 -48.0% 收斂到 -43.5%。擇時在 2022 年確實少跌,但 2018 年那段反而跌得更深,2020 年 3 月疫情急跌也來不及反應。原因是擇時只在每月再平衡日判斷,常在急跌之後才空手,等反彈走了一段才回到市場;錯過反彈的代價遠大於交易成本,擇時版的月周轉率(48%)其實還低於原始版(59%)。下檔保護要有效,通常需要比單一均線更細緻的設計。
月營收成長動能策略會一直有效嗎?
沒有人能保證。本文雖然做了 walk-forward,近 9 年(2018 到 2026)的歷史優勢仍可能因市場結構改變、因子擁擠而衰減;2026 年 6 到 8 月的回落就是一次提醒。能做的是每季用新資料重跑、據實更新;數據惡化就在文中標記衰退,不調參硬撐。這也正是用 Hermes 排程的理由:它每月自動重跑並把績效寫進記憶,衰退在下一次重跑就會被標出來,不必等你某天想起來才檢查。
不會寫 Python 也能做嗎?
可以。策略邏輯全用中文描述給 Hermes,程式由它產生、finlab 負責資料與回測。不過看得懂基本程式對你有利,因為你能檢查 AI 有沒有用到未來資料、成本有沒有扣。想補底子,Python 量化交易教學 會帶你從設定到第一個台股回測。
這支策略要多少資金才適合?
學習與回測完全免費。實際執行面,策略持有 20 檔、平方加權,台股以張為單位(零股亦可),數十萬以上比較貼近權重配置。策略偏中小型成長股,資金規模大到單筆買賣影響股價時,回測與實單的差距會擴大;流動性門檻只保證每檔近 20 日平均成交金額超過 1,000 萬,本文未估算容量上限。
為什麼用平方加權,不用等權?
平方加權讓綜合分數最高的股票拿到更高權重,把資金集中到訊號最強的標的。實測下來差別很小:同樣前 20 檔,平方加權年化 25.9%、月索提諾 1.67,等權年化 25.7%、月索提諾 1.65,最大回撤也只差 0.1 個百分點,資料截止日平方加權的單檔權重也只落在 4.5% 到 5.6%。真正影響結果的是持股數:放寬到 40 檔,回撤只從 -48.0% 變成 -44.3%,年化卻降到 23.7%、低於 0050 的 24.3%。想要更簡單的版本,用等權即可。
下一步:三條路徑直接開始
- 零安裝:打開 FinLab Studio,用瀏覽器直接輸入選股條件跑回測。
- 本機 AI 工具:在自己的電腦安裝 Hermes,接雲端模型或本地模型,裝好 finlab skill 後重現本文策略。
- 長期排程:把 Hermes 放在小型 VPS 或 serverless 環境,排每月 11 號重跑並把結果送到 Telegram/Discord。
- 加入社群:FinLab Discord 裡有上千位台股量化同好,策略卡關、回測結果怪異都可以直接貼出來討論。
下載與重現
- strategy.py:月營收成長動能三因子完整原始碼,執行後印出本文績效表與敏感度表的數字(主策略、naive 擇時、前 20 等權、前 30/前 40、樣本外與同窗 0050,含年化波動、平均持股與月周轉率)和資料截止日的 20 檔持股權重
- data.csv:策略、naive 對照與 0050 含息的每日淨值(2018-01-31 同起點)
- metrics.json:全部指標的機器可讀快照(含重跑日與 finlab 版本)
- 互動式回測報告:月營收成長動能三因子
延伸閱讀:想看 AI Agent 從零做台股量化的完整三段對話,參考 AI Agent 量化交易實戰;想看更多現成的選股提示詞與回測,參考 AI 選股提示詞 30 條與真實回測 與 AI 提示詞回測策略。
投資警語:本文僅供教學參考,不構成投資建議。文中全部回測數據(年化 25.9%、最大回撤 -48.0% 等)為 2018-01 至 2026-08 的歷史模擬,已含 finlab 預設交易成本,但未含滑價與容量限制;過去績效不代表未來表現。本策略最大回撤達 -48.0%,代表 100 萬可能一度縮水至約 52 萬,請依個人風險承受度審慎評估,僅使用虧損不影響生活的閒置資金。
最後更新:2026-10|回測區間:2018-01 ~ 2026-08(資料截至 2026-08-31,2026-10-10 重跑)|作者:FinLab 量化研究團隊(經量化研究員審閱)
FinLab AI
Want to build your own strategy?
Describe your stock-picking ideas in natural language. AI automatically validates, backtests, and gives you answers
Start Free